
SEO如何让网站被看见:从搜索引擎发现到用户转化
拆解Google发现、抓取、渲染、收录和排名网页的完整过程,并提供Sitemap、robots.txt、Canonical、内链、点击与转化的排查方法。
本文不承诺收益,只说明适用条件、操作步骤和风险边界。
这篇文章帮你完成什么
拆解Google发现、抓取、渲染、收录和排名网页的完整过程,并提供Sitemap、robots.txt、Canonical、内链、点击与转化的排查方法。
- 你的任务
- 理解网页从发布到获得Google曝光的完整链路,并判断网站卡在发现、抓取、收录、排名还是转化环节
- 完成标准
- 能做出明确选择、完成首轮配置,并知道失败后从哪里排查。
你发布了一篇文章,并不代表Google已经知道它的存在。Google发现页面,也不代表一定会抓取;抓取成功,不代表一定收录;进入索引,也不代表能够获得排名。
SEO真正解决的问题,不只是“写文章”或者“堆关键词”,而是帮助搜索引擎找到页面、理解页面,再把页面推荐给真正需要它的用户。
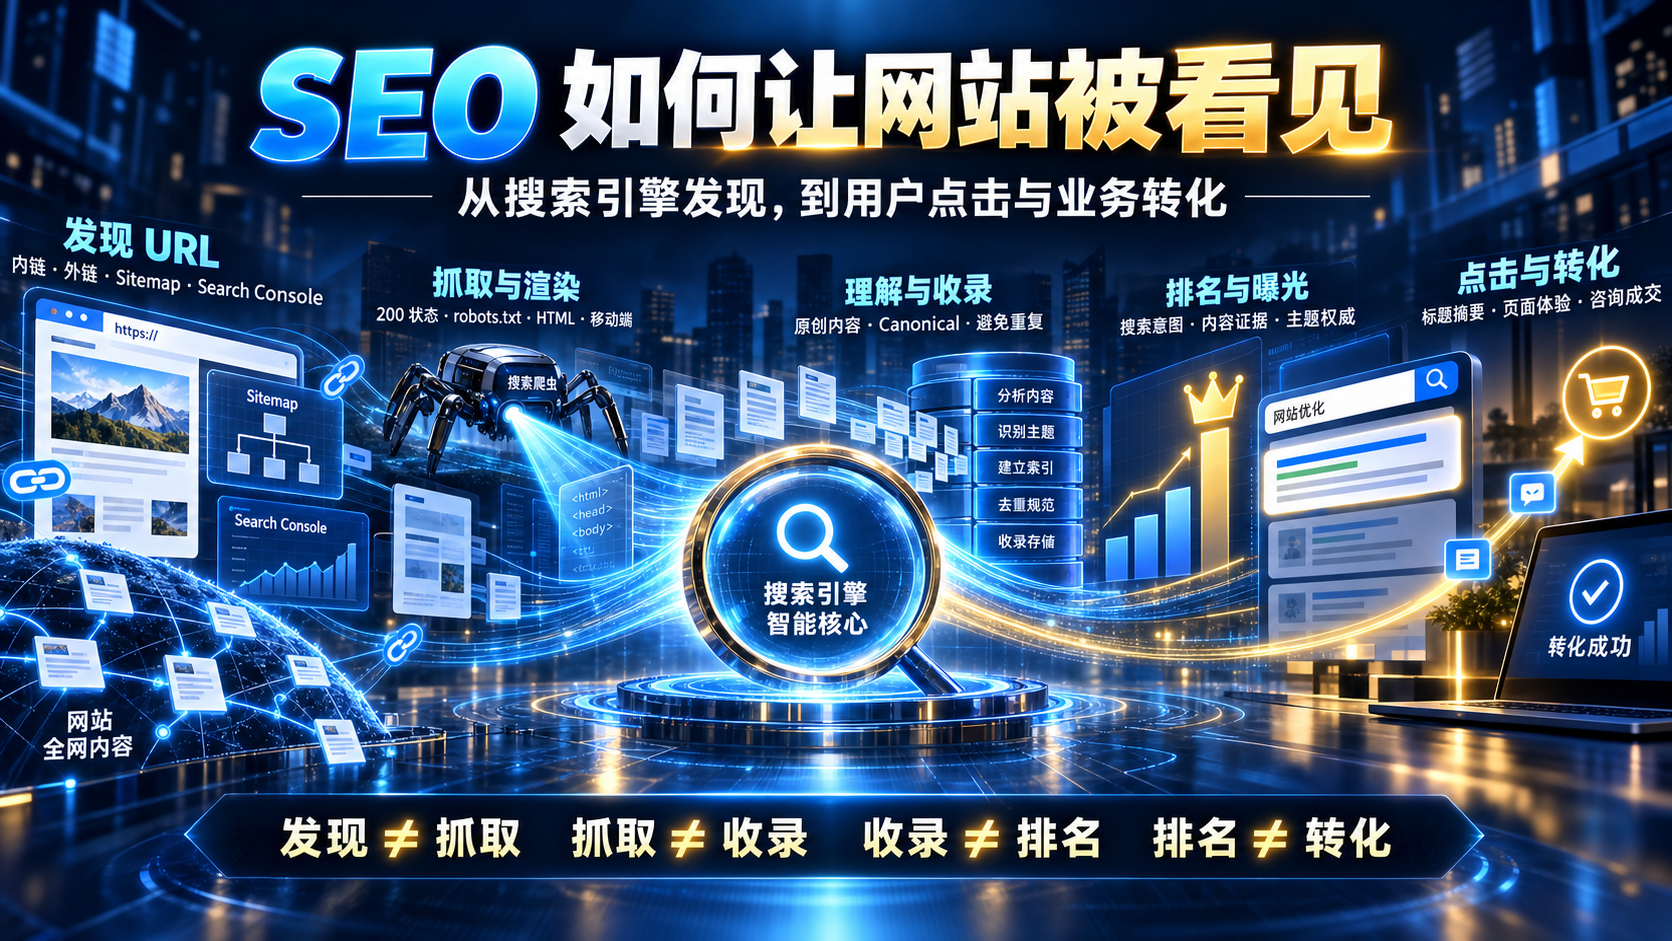
先看清SEO的完整链路
发现URL → 抓取页面 → 渲染理解 → 判断收录
       → 计算排名 → 展示与点击 → 阅读与转化
可以把整条链路分成四层:
| 层级 | 核心问题 | 判断结果 |
|---|---|---|
| 技术基础 | 搜索引擎能否发现、访问和理解页面 | 页面是否具备参与收录的条件 |
| 内容价值 | 页面是否完整解决一个真实问题 | 页面是否值得进入索引 |
| 主题权威 | 网站是否持续覆盖该领域 | 页面是否有能力参与竞争 |
| 商业结果 | 点击后是否产生阅读、咨询或购买 | SEO是否真正形成业务价值 |
理解这条链路以后,我们才有可能判断网站究竟卡在哪里。只观察“有没有排名”,很容易把发现、抓取、收录和内容质量问题混在一起。
一、搜索引擎如何发现网站
互联网没有一个登记所有网站的中央目录。Google主要依靠Googlebot持续访问互联网,从已知页面中提取新的链接,再把新发现的URL加入待抓取列表。Google官方将这个过程称为URL发现。
通过站内链接发现
假设Google已经知道网站首页,它可以继续沿着“首页 → 分类页 → 文章详情 → 相关文章”的链接关系发现更多页面。
**关键检查:**每一个准备参与搜索排名的重要页面,都应该至少被另一个可抓取页面链接。只能通过站内搜索框找到的页面,很可能成为孤岛页面。
锚文本也应该说明目标页面的内容。相比“查看更多”,“Google网站收录检查方法”能向用户和搜索引擎提供更明确的上下文。
通过Sitemap发现
Sitemap相当于网站主动提供的一张URL清单,特别适合刚上线、外链较少、一次发布较多内容的网站。
<url>
  <loc>https://example.com/articles/google-indexing-guide/</loc>
</url>Sitemap只能帮助Google发现URL,不能保证页面一定被抓取或收录。清单中应只保留正式、公开、返回200状态,并且希望参与搜索排名的规范页面。
通过外链和Search Console发现
当行业网站、社区文章或合作伙伴引用页面时,Google也可能顺着外链找到网站。对于少量重要页面,还可以在Search Console的网址检查工具中主动请求编入索引。
**不要误解:**重复请求编入索引不会让抓取自动变快,也不能替代良好的内链、Sitemap与页面质量。
二、Google如何抓取与渲染页面
Google知道URL存在后,会判断是否访问它、什么时候访问,以及需要下载哪些资源。这个阶段首先检查的是页面可访问性,而不是关键词写了多少次。
抓取阶段需要完成的工作
- 页面返回正常的
200 OK状态。 - HTTPS证书有效,域名和服务器保持稳定。
robots.txt没有误封核心页面与必要资源。- 页面不要求登录,CSS、图片和JavaScript可以加载。
- 旧地址通过301跳转到唯一的新地址。
- 避免大量参数URL和重复筛选页面消耗抓取资源。
robots.txt与noindex不是一回事
robots.txt主要控制搜索引擎是否可以抓取URL;noindex主要控制页面是否可以出现在搜索结果中。如果禁止Googlebot抓取页面,它可能无法读取页面中的noindex规则。
Google官方也明确说明:robots.txt主要用于管理抓取流量,不应该被当作隐藏网页的可靠方式。
渲染阶段需要完成的工作
Google抓取HTML后,还会解析文字、图片和JavaScript。对于Astro静态网站,核心优势是正文可以直接输出在HTML中,不需要等待复杂脚本执行。
- 核心正文直接存在HTML里。
- 主内容不依赖点击Tab后才加载。
- 图片具有准确的alt说明。
- 手机端与桌面端提供相同的核心信息。
- 广告、弹窗和装饰图片不遮挡正文。
三、抓取成功,为什么还是没有收录
抓取以后,Google会尝试理解页面主题、内容质量、重复程度和规范版本,然后决定是否放入搜索索引。即使页面在技术上完全可访问,Google也不保证一定将它收录。
内容过于简单
如果一个工具详情页只有工具名称、一句话介绍和官网按钮,它很难证明自己比官方网站或其他导航站更有价值。增加字数也不是答案,关键是增加能够帮助用户完成任务的信息。
页面高度重复
如果24个工具详情页使用同一套模板文字,只替换工具名称,搜索引擎可能把它们理解为批量生成的低价值页面。每个页面都需要独立的适用场景、测试过程、限制、价格、风险和结论。
Canonical或noindex设置错误
<link rel="canonical"
href="https://example.com/tools/zapier/">Canonical应该指向当前内容真正的规范URL。搜索页、空标签页和不完整页面可以设置noindex,但核心文章不能误设。
**收录判断:**页面应该具备独立价值,包括适用对象、操作步骤、成本、限制、风险、数据来源,以及与其他方案的区别。
四、进入索引后,如何获得排名
收录只是获得了参与排名的资格。当用户搜索时,Google需要在大量页面中选择相关、可靠并且更有帮助的结果。
搜索意图比关键词密度更重要
用户搜索“Cloudflare Pages如何部署Astro网站”,通常希望立刻看到构建命令、输出目录、GitHub部署、常见错误和验证方法。如果文章大量介绍“什么是网站”,即使关键词出现很多次,也没有解决真实问题。
原创证据比泛泛总结更重要
一篇能够建立信任的教程,至少应该记录以下内容:
| 测试项目 | 应该记录的内容 | 对读者的价值 |
|---|---|---|
| 测试时间 | 发布时间、核验时间和观察周期 | 说明信息时效 |
| 真实场景 | 网站类型、技术栈和目标页面 | 限定结论边界 |
| 配置参数 | 构建命令、Node版本、输出目录 | 让读者可以复现 |
| 遇到问题 | 错误信息、原因和修复过程 | 体现第一手经验 |
| 最终结论 | 适合对象、限制和替代方案 | 帮助用户做决定 |
稳定排名通常来自搜索意图、内容证据、主题集群、合理内链、相关外链和良好体验共同作用,而不是某一个SEO技巧。
五、排名之后,还要解决点击与转化
搜索曝光不等于网站访问。用户首先看到网站名称、标题、URL和摘要,因此标题必须准确说明文章解决什么问题。
| 类型 | 标题示例 | 判断 |
|---|---|---|
| 普通标题 | SEO基础介绍 | 范围模糊,缺少点击理由 |
| 清晰标题 | SEO如何让网站被Google发现、收录并获得排名 | 对象、过程和结果明确 |
用户进入网站以后,需要快速获得答案,继续阅读相关内容,并清楚知道下一步可以下载资料、咨询、注册还是购买。完整链路应该是:
搜索曝光 → 用户点击 → 阅读内容
       → 查看相关页面 → 下载或咨询 → 注册或购买
六、用数据判断SEO卡在哪个环节
不要把所有问题都归结为“排名不好”。先观察事实,再判断它属于哪一层。
| 观察现象 | 可能原因 | 优先动作 |
|---|---|---|
| Google不知道URL | 缺少内链或Sitemap | 补充导航、分类和相关文章链接 |
| 已发现但未抓取 | 网站新、优先级低或服务器异常 | 检查稳定性、内容质量与内链 |
| 已抓取但未收录 | 重复、薄内容或规范页错误 | 增加独立价值并检查Canonical |
| 已收录但没有展现 | 缺少明确搜索需求 | 重新匹配关键词和搜索意图 |
| 有展现但点击较少 | 标题摘要缺乏吸引力 | 重写Title和Description |
| 有点击但快速离开 | 内容和需求不匹配 | 重写开头、目录和核心答案 |
| 有阅读但没有转化 | 缺少下一步入口 | 增加清单、工具、咨询或产品 |
七、文章发布检查清单
发布前
- 页面只解决一个明确主题。
- Title、H1与搜索意图一致。
- 内容包含步骤、数据和原创证据。
- 图片具有准确的alt说明。
- Canonical和robots配置正确。
- 手机端可读并返回
200状态。
发布后
- 从分类页和相关文章建立链接。
- 确认页面进入Sitemap。
- 使用Search Console检查URL。
- 记录发布日期和核验日期。
- 观察真实查询词与点击率。
- 根据用户问题持续补充内容。
结论:SEO不是让Google看见更多页面
真正有效的SEO,是让Google清楚地知道:这个网站在解决什么问题,这个页面为什么值得推荐给用户。
发现靠链接,抓取靠技术,收录靠价值,排名靠匹配与权威,转化靠体验与产品。
不要一次修改所有东西。先通过Search Console确认页面卡在哪个环节,再针对那个环节做最小、可验证的调整。
资料与核验
更新于 2026/9/15产品功能、价格和平台政策可能变化。以下为本文实际核验采用的公开资料,建议操作前再次确认。
执行前常见问题
提交Sitemap后,Google会立即收录页面吗?
不会。Sitemap可以帮助Google发现URL,但不能保证Google一定抓取、收录或给予排名。
页面已抓取但未编入索引,应该先做什么?
先检查页面是否与站内其他页面重复、是否具备独立价值、Canonical是否正确,以及分类页和相关文章是否提供了有效入口。
robots.txt可以阻止网页出现在Google结果中吗?
robots.txt主要管理抓取,不适合作为隐藏网页的手段。需要阻止网页进入搜索结果时,应使用noindex或访问控制,并确保搜索引擎可以读取相关指令。
页面已收录但没有流量,是技术SEO问题吗?
不一定。页面已收录说明具备参与排名的资格;没有展现或点击,通常还要检查搜索需求、搜索意图、内容证据、标题摘要和站点主题权威。